视频生成 · 学习地图¶
先把“生成方法”“神经网络”“压缩表示”分开,你就能读懂这些模型的大半架构图。 Diffusion / Flow Matching 规定如何学会从噪声生成样本;Transformer 是处理序列的网络;DiT 是用 Transformer 做扩散建模;VAE 把视频转成更小的连续潜变量。这些组件可以同时出现在一个系统里。DDPM、DiT、LDM 分别给出了这些层次的经典实例。
先认出一条完整数据流¶
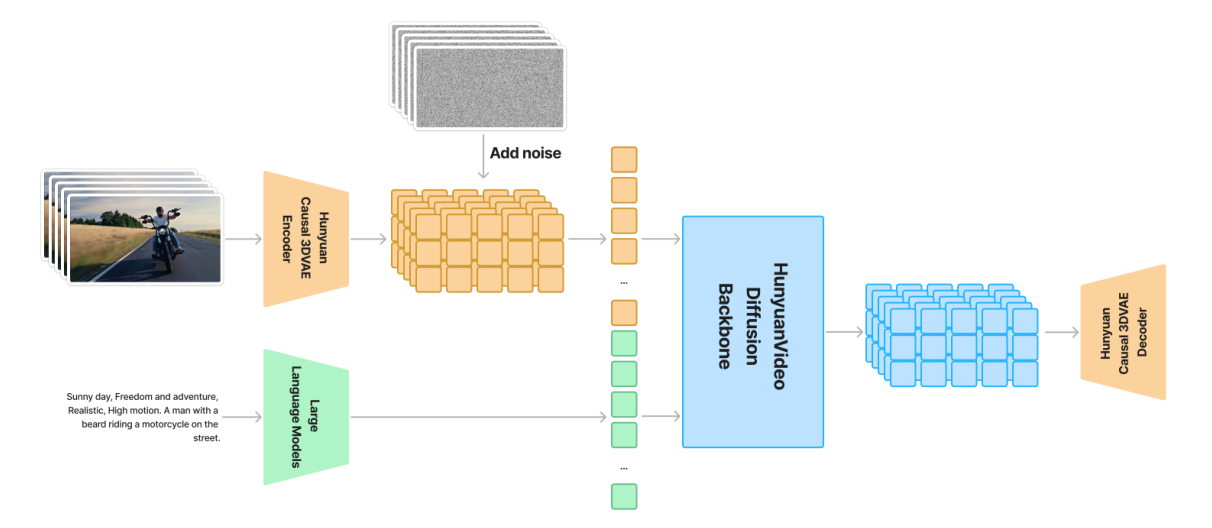
从左向右看这张图,先只找五个位置:
- 视频 → VAE encoder:训练时把真实视频压缩成 latent。文生视频推理时没有真实视频,这一支不需要执行。
- 文字 → text encoder:把提示词变成条件表示。这里输出的是数值向量,不是最终视频。
- 噪声 → diffusion backbone:训练时加噪构造习题,推理时从随机噪声开始解题。
- 反复调用主干:每次网络输出一个更新方向,采样器据此修改当前 latent。同一个网络会被调用很多次。
- latent → VAE decoder:最后才把较小的潜变量还原成 RGB 视频。HunyuanVideo §4
图把训练与生成画在一起,因此不能将左边所有箭头都理解成“用户点生成之后会执行的步骤”。这也是阅读此类论文图时最容易混淆的地方。
阅读顺序¶
-
Diffusion 与 Flow Matching · 约 25 分钟
噪声怎样成为训练信号,为什么生成要迭代
-
Transformer 与 DiT · 约 30 分钟
Q/K/V、注意力、条件调制与视频 token
-
VAE 与视频潜空间 · 约 25 分钟
压缩倍率、因果卷积、张量形状与 token 数
-
HunyuanVideo 与 Wan · 约 35 分钟
从每一条条件分支读出主干的区别
-
MiniMax-H3 · 约 30 分钟
视频、音频、文本怎样进入同一个 Transformer
-
对比与自测 · 约 20 分钟
版本对照、术语速查、张量计算和检验理解
阅读时间是学习建议,不是论文数据。第一遍先读图和直觉,第二遍再核对公式与源码入口。
笔记、论文、视频怎样搭配¶
不必先看完所有材料。每读完一章,选一篇对应论文和一段讲解,再用导读中的问题检查理解。
| 当前阶段 | 论文导读 | 配套视频 |
|---|---|---|
| 加噪、训练与采样 | DDPM、Flow Matching | 中文入门、MIT Lecture 1–3 |
| 注意力与模型主干 | DiT | 3Blue1Brown |
| 潜空间与条件生成 | LDM | VAE 课程、MIT Lecture 4 |
| 从图像走向视频 | Video Diffusion Models、Stable Video Diffusion | 回看条件生成课程,再对照视频论文中的时间层与训练阶段 |
| 因果视频与长序列 | Diffusion Forcing、Self Forcing | Boyuan Chen 作者报告 |
HunyuanVideo 与 Wan 的模型导读仍在架构笔记中;完成视频建模部分后,再进入自回归推理效率。
论文版本¶
| 本系列名称 | 实际范围 | 为什么这样选 |
|---|---|---|
| HunyuanVideo | 2024 年原始 13B T2V,论文 v1 | 架构公开完整;可衔接已有源码笔记 |
| Wan | Wan 2.1 T2V 1.3B / 14B;另外解释 Wan 2.2 A14B、TI2V-5B | 2.1 适合学基础;2.2 用来解释专家分工和更高压缩 |
| MiniMax-H3 | 官方 2026-07-31 发布的开源 Omni 模型及固定源码版本 | 与本地 H3 推理研究对应;不是早期 Hailuo 产品的泛称 |
Hunyuan 与 Wan 都是模型家族名称。本系列不是“截至今天所有版本”的盘点,不能将初版参数直接用于新 checkpoint。HunyuanVideo、Wan 2.1、Wan 2.2 官方仓库、H3 官方发布
阅读后你应该能够回答¶
- DiT 的一次 forward 为什么不是完整的一次生成?
- 文本的 token、视频的 token、latent channel、hidden dimension 为什么是四个不同概念?
- Causal VAE 为什么不意味着 DiT 必须逐帧生成?
- HunyuanVideo 双流块是否允许图文交流?Wan 的文本是不是也变成生成目标?
- H3 的三种模态进入一个序列之后,能不能直接套用 LLM 的 KV cache?
答案在各章末尾和对比自测。进一步读实现时,再进入原有的 HunyuanVideo 源码与数学推导与自回归视频扩散推理效率。